OpenAI ‘FrontierScience’ Benchmark Sonuçlarının Sağlık Sektörü İçin Derinlemesine Analizi
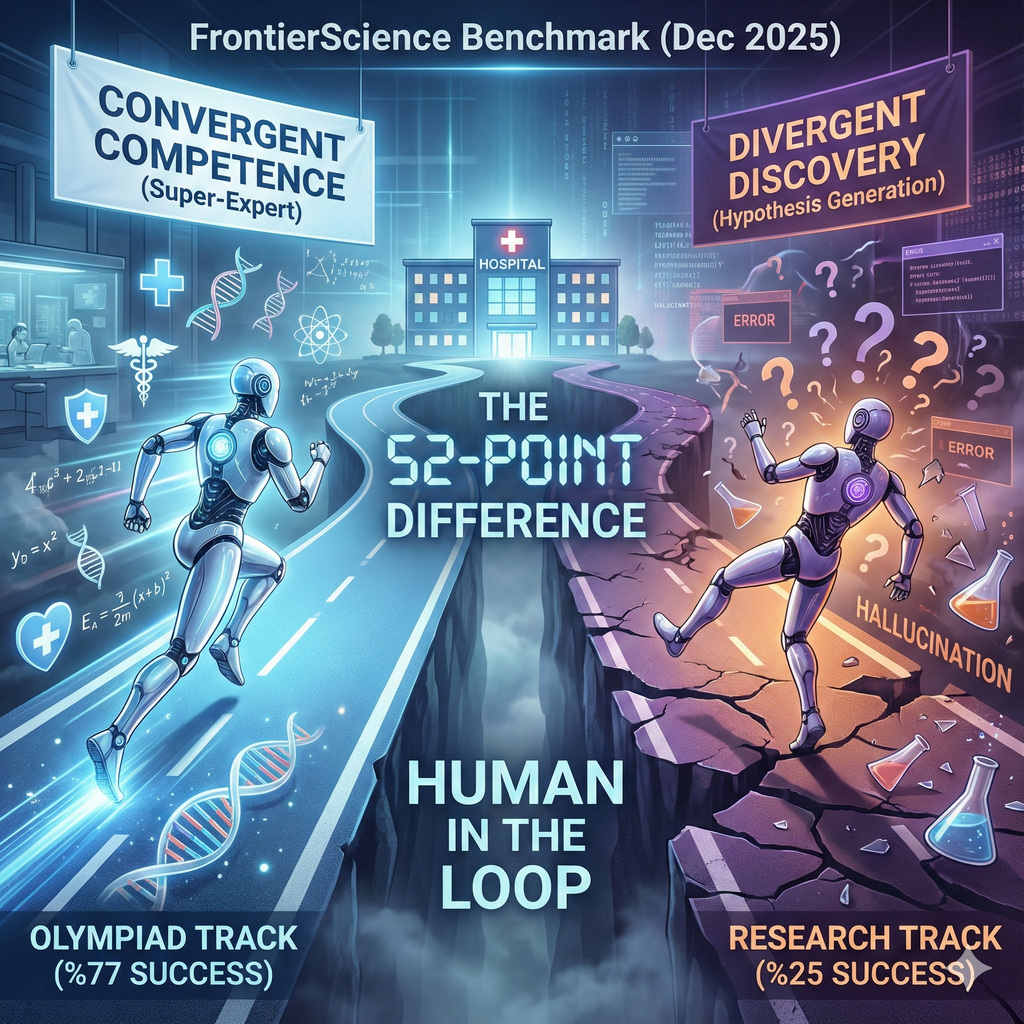
15 Aralık 2025’te yayınlanan OpenAI FrontierScience benchmark (kıyaslama) sonuçları, biyomedikal dünyasında sadece teknik bir rapor değil, adeta bir “uyandırma servisi” etkisi yarattı. Manşetlere baktığınızda herkesin %77’lik başarı oranını konuştuğunu göreceksiniz (OpenAI, 2025). Evet, bu oran modellerin fizik, kimya ve biyoloji olimpiyatı düzeyindeki soruların büyük kısmını çözebildiğini gösteriyor.
Ancak sağlık yöneticileri ve bizler için asıl kritik sinyal, o parlak manşetlerin gölgesinde kalan %25’lik Araştırma (Research) skorunda yatıyor (FrontierScience makalesi, arXiv 2026).
Bu 52 puanlık devasa uçurum, bize Büyük Dil Modellerinin (LLM) sınırlarını çok net bir dille anlatıyor: Yapay zeka, ders kitaplarını yutmuş bir öğrenci gibi her şeyi biliyor (sentez); ama laboratuvara girip yeni bir şey keşfetmesi gerektiğinde (özgün hipotez) eli ayağına dolaşıyor.
Gelin, bu durumun hastanelerimiz, laboratuvarlarımız ve tıp eğitimimiz için ne anlama geldiğine, teknik jargonun arkasına saklanmadan bakalım.
I. İki Farklı Zeka Türü: Kitap Zekası vs. Sokak (Laboratuvar) Zekası
GPT-5.2, Claude 4.5 veya Gemini 3 Pro gibi modellerin hastanenizde ne işe yarayacağını anlamak için, FrontierScience’ın yaptığı şu temel ayrımı kabul etmemiz gerekiyor:
1. Olimpiyat Kulvarı: “Cevabı Belli Olan Sorular” (Yakınsak Yetkinlik)
Burası, uluslararası fizik, kimya ve biyoloji olimpiyatları gibi üst düzey bilgi yarışmalarının dünyasıdır. Sorular çok zordur, karmaşık mantık gerektirir ama günün sonunda tek bir doğru cevabı vardır.
- Yapay Zekanın Durumu: %77 başarı.
- Ne Anlama Geliyor? Model adeta bir “Süper-Uzman”. Yerleşik bilimsel bilgileri ve biyolojik kuralları çok iyi biliyor. Cevabı belli, ders kitabı düzeyindeki sorularda hata yapma ihtimali görece düşük.
2. Araştırma Kulvarı: “Bilinmeze Yolculuk” (Iraksak Keşif)
Burası, modelin bir Doktora öğrencisi gibi davranması gereken yerdir. Ham veriyi analiz etmeli, işler ters gittiğinde “neden” diye sormalı ve yeni deneyler tasarlamalıdır.
- Yapay Zekanın Durumu: %25 başarı.
- Ne Anlama Geliyor? Model bilgiye sahip ama muhakeme yeteneği kısıtlı.
- Stratejik Ders: Biz şu ana kadar olimpiyat düzeyindeki bilim sorularını çözen bir yapay zekayı kutladık ama “Baş Araştırmacı” (Principal Investigator) olabilecek bir zekayı henüz üretemedik. Yatırımlarımızı planlarken YZ’yi “Doktorun Yerine Geçecek” biri olarak değil, “Süper Analist Bir Asistan” olarak konumlandırmalıyız.
II. 52 Puanlık Fark Neden Bir Güvenlik Sorunudur?
Olimpiyat ve Araştırma skorları arasındaki bu uçurum sadece akademik bir istatistik değil; klinik deneyler için ciddi bir güvenlik uyarısıdır.
İlaç Keşfinde “Kağıt Üstünde Mükemmel” Yanılgısı
Bir sınav sorusunda değişkenler sabittir. Ancak Faz II klinik deneylerinde, insan biyolojisi sürekli değişir. %77’lik sınav başarısı, yapay zekanın bir ilacın kimyasal tepkimesini ezbere bildiğini gösterir. Ancak %25’lik araştırma skoru, birden fazla hastalığı olan (multi-morbidite) karmaşık bir hastada, bu ilacın yaratacağı zincirleme reaksiyonları öngörmekte zorlanacağı anlamına gelir.
Sağlık Yöneticileri İçin Risk Haritası
- Protokol Kayması (Protocol Drift): Araştırma yeteneği zayıf bir YZ, kulağa çok mantıklı gelen ama biyolojik olarak geçersiz hasta eleme kriterleri uydurabilir (Halüsinasyon).
- Sıradışı Durum Çöküşü: Sınav odaklı bir model, standart dışı bir hasta reaksiyonunu “düzeltilmesi gereken bir gürültü” olarak görebilir. Oysa tıpta o anormallik, genellikle en hayati sinyaldir.
III. Devlerin Savaşı: Modeller Nasıl Karşılaştırılıyor?
OpenAI bir standart belirlemiş olsa da, 2025 sonu itibarıyla elimizdeki araçlar farklı yeteneklere sahip. Her hastanenin ihtiyacına göre “atın eyerine göre” seçim yapmak şart.
| Özellik | GPT-5.2 (OpenAI) | Claude 4.5 (Anthropic) | Gemini 3 Pro (Google) |
| Sınav Skoru | %77 (Zirve) | %71 | %76 |
| Araştırma Skoru | %25 | %18 | – |
Özetle: Tablodaki puanlar (The Decoder, Aralık 2025) modellerin bu iki kulvardaki performansını gösterir; hangi modelin hangi klinik görevde daha uygun olduğu ise kurumun kendi verileri ve senaryolarıyla yapacağı testlerle belirlenmelidir.
IV. Bir Başarı Öyküsü: DNA Klonlama ve “Lojistikçi” Yapay Zeka
Genel araştırma skoru düşük olsa da, OpenAI’nin FrontierScience’tan ayrı olarak Red Queen Bio ile yürüttüğü bir çalışmada çok ilginç bir detay var: DNA klonlama protokollerinde 79 kat iyileşme.
Bu neden önemli? Çünkü DNA klonlama, ucu açık bir bilimsel keşiften ziyade, kuralları çok net olan (deterministik) bir “yemek tarifi” gibidir. Enzimlerin nasıl kesip yapıştıracağı bellidir.
Ders: Yapay zeka henüz “Nobel ödüllük bir hipotez” kuramıyor olabilir ama mükemmel bir Laboratuvar Müdürü olmaya hazır. Lojistiği, hesaplamaları ve protokolleri insanlardan çok daha hızlı ve hatasız yönetebilir.
V. Kendi Kendini Puanlayan Öğrenci Sorunu
FrontierScience raporuna eleştirel bir gözle baktığımızda teknik bir tuzak görüyoruz: Puanlayıcı Sorunu.
Modeller o kadar karmaşıklaştı ki, onları puanlamak için yine başka yapay zeka modelleri (GPT-5 tabanlı sistemler) kullanılıyor. Bu, bir öğrencinin kendi kağıdını okumasına benziyor.
- Risk: Eğer puanlayan model ile test edilen model, aynı yanlış bilgiye sahipse (örneğin yeni bir gen düzenleme tekniği hakkında ortak bir yanılgı), birbirlerini “doğru” olarak onaylayabilirler.
- Gerçek: Akademik dünyada ve tıpta tek gerçek “kanıt”tır. Hasta iyileşti mi? Deney tekrar edilebildi mi? “%77 başarı” skoruna körü körüne güvenemeyiz; bu skor modelin ne kadar doğru olduğunu değil, başka bir modeli ne kadar iyi ikna ettiğini gösterir.
VI. Gelecek İçin Stratejik Yol Haritası
Sağlık Yöneticileri (CTO/CMIO) İçin:
- İnsan Döngüden Çıkamaz: Klinik araştırmalarda otomasyona geçmeyin. YZ’ye 20 farklı protokol hazırlatın ama son kararı ve doğrulamayı mutlaka bir insan uzmana (PI) bırakın. %25 başarı, otonomi için çok düşük.
- Görev Dağılımı Yapın: Hangi modelin hangi işte (arka ofis, tanı desteği, hasta iletişimi) kullanılacağına, kurumunuzun kendi senaryolarıyla yapacağı testlere göre karar verin.
- Hızlı Kazanımlara Odaklanın: Klonlama örneğindeki başarı, laboratuvar lojistiği ve operasyonel verimlilikte (patoloji süreçleri vb.) yapay zekanın hemen şimdi büyük fayda sağlayacağını gösteriyor.
Tıp ve STEM Öğrencileri İçin:
- Ezberi Bırakın: Karşınızda olimpiyat düzeyindeki bilim sorularında %77 alan bir makine var. Değeriniz artık Krebs döngüsünü ezbere bilmekte değil.
- Tasarımcı ve Denetçi Olun: Model araştırmada sadece %25 alabiliyor. Sizin farkınız, YZ’nin tasarlayamadığı deneyleri kurgulamak ve YZ’nin “mantıklı gibi gelen” hatalarını yakalamak olacak. Geleceğin doktoru, aynı zamanda iyi bir “YZ Denetçisi” olmak zorunda.
Sonuç: Sınır Hattı Hâlâ Engebeli
FrontierScience benchmark sonuçları bize şunu söylüyor: Elimizde “Yapay Bir Lisans Öğrencisi” var. Sınavları geçme konusunda dahi seviyesinde, ancak gerçek dünyanın belirsizliklerle dolu araştırma ortamında hala bocalıyor.
Sağlık sektörü için bu sonuçlar; tanısal destek için “Yeşil Işık”, ancak otonom (kendi başına) araştırma ve karar verme için yanıp sönen bir “Sarı Işık”tır. 52 puanlık fark sadece bir istatistik değil, insan uzmanlığının hala doldurulamaz olduğunun kanıtıdır.
Sıkça Sorulan Sorular: FrontierScience ve Sağlığın Geleceği
Soru: OpenAI FrontierScience sonuçları sağlıkçılar için ne anlama geliyor?
Cevap: GPT-5.2 gibi modellerin olimpiyat düzeyindeki bilim sorularında “Süper-Uzman” (%77 başarı) olduğunu, ancak yeni bilimsel keşiflerde (%25 başarı) henüz “çaylak” seviyesinde kaldığını gösteriyor. Tanı desteği için harikalar ama araştırmada tek başlarına bırakılamazlar.
Soru: Neden sınavda çok iyiyken araştırmada başarısızlar?
Cevap: Çünkü sınavlar “kitap bilgisini” (Yakınsak Zeka) ölçer, araştırma ise “belirsizlikle başa çıkmayı ve yaratıcılığı” (Iraksak Zeka) gerektirir. Yapay zeka bildiğini unutmuyor ama bilinmeyeni yönetmekte zorlanıyor.
Soru: Hangi modeli seçmeliyim?
Cevap: FrontierScience sonuçları tek başına model seçimi için yeterli değildir; seçimi, kurumunuzun kendi görevleri üzerinde yapacağınız kontrollü testlere göre yapın.
Soru: Yapay zeka klinik deneyleri tek başına yönetebilir mi?
Cevap: Kesinlikle hayır. Biyolojik karmaşıklığı ve beklenmedik hasta tepkilerini yönetmekte henüz yetersizler. Mutlaka doktor kontrolü şart.
Soru: OpenAI’nin ayrı çalışmasındaki “DNA Klonlama” başarısı neyi ifade ediyor?
Cevap: Yapay zekanın kuralları belli olan laboratuvar süreçlerini ve lojistiği planlamada insanlardan çok daha hızlı ve hatasız olabileceğini (79 kat iyileşme) kanıtlıyor. Yaratıcılıkta değil ama uygulamada devrim yaratabilirler.
Güncelleme (Ekim 2026)
Bu yazı Ekim 2026’da gözden geçirildi. Aşağıdaki notlar, yazının yayımlandığı tarihten bu yana yaşanan gelişmeleri güncel ve kaynaklı verilerle özetler.
FrontierScience’ın ayrıntılı makalesi Ocak 2026’da yayımlandı. Açık paylaşılan altın set 100 olimpiyat ve 60 araştırma sorusundan oluşuyor; araştırma soruları fizik, kimya ve biyoloji arasında eşit dağılıyor. Araştırma yanıtları 10 puanlık bir değerlendirme ölçeğiyle puanlanıyor ve 7 puan ve üzeri başarı sayılıyor; puanlamayı yüksek akıl yürütme düzeyinde çalışan bir GPT-5 modeli yapıyor. Yayımlanan sonuçlara göre olimpiyat bölümünde GPT-5.2 %77, Gemini 3 Pro %76 ile birbirine çok yakın; araştırma bölümünde ise GPT-5.2 %25, Claude Opus 4.5 %18 aldı. (FrontierScience makalesi, arXiv 2026; The Decoder, Aralık 2025)
Sınav başarısının gerçek kullanıma doğrudan yansımadığını gösteren güçlü bir kanıt Şubat 2026’da Nature Medicine’de yayımlandı. Oxford merkezli, ön kayıtlı ve randomize bu çalışmada 1.298 katılımcı on tıbbi senaryoda GPT-4o, Llama 3 veya Command R+ kullandı. Modeller tek başına durumları %94,9 oranında doğru tanımlarken, modelleri kullanan katılımcılar ilgili durumu %34,5’ten az, doğru yönlendirmeyi %44,2’den az vakada buldu ve kontrol grubundan daha iyi sonuç almadı. Yazarlar, sağlıkta kamuya açık kullanımdan önce gerçek kullanıcılarla sistematik test yapılmasını öneriyor. (Bean ve ark., Nature Medicine 2026 (Oxford ORA kaydı))
Ocak 2026’da büyük model geliştiricileri sağlığa özel ürünler duyurdu. OpenAI’ın ChatGPT Health ürünü kullanıcıların sağlık kayıtlarını bağlamasına imkân veriyor ve AB, İsviçre ve Birleşik Krallık dışında bekleme listesiyle açıldı. Anthropic’in Claude for Healthcare ürünü ise ağırlıklı olarak sağlayıcı ve ödeyici kurumlara yönelik; PubMed, NPI kaydı ve CMS kapsam veritabanı gibi kaynaklara bağlayıcılar sunuyor. (DeepLearning.AI The Batch, 2026; MobiHealthNews, 2026)
Düzenleme tarafında AB Yapay Zekâ Yasası’nı değiştiren Dijital Omnibus düzenlemesi (AB 2026/1744) 24 Temmuz 2026’da Resmî Gazete’de yayımlanarak yürürlüğe girdi. Buna göre bağımsız yüksek riskli yapay zekâ sistemlerine ilişkin yükümlülükler 2 Aralık 2027’ye, tıbbi cihazlar gibi ürün mevzuatı kapsamındaki sistemlere ilişkin yükümlülükler ise 2 Ağustos 2028’e ertelendi. AB pazarına yönelik çalışan hastaneler ve yazılım sağlayıcıları uyum planlarını bu yeni tarihlere göre gözden geçirmeli. (Cuatrecasas, 2026; Hogan Lovells, 2026)
Kaynakça ve İleri Okuma
Bu analizde kullanılan veriler ve temel alınan bilimsel çalışmalar aşağıdadır:
- YZ’nin Sınav Performansı: Nori, H., et al. (2023). “Capabilities of GPT-4 on Medical Challenge Problems.” Microsoft Research. (Sınav başarısı ile klinik pratik arasındaki farkı gösteren temel çalışma). (arxiv.org)
- Tıpta LLM Kullanımı: Thirunavukarasu, A. J., et al. (2023). “Large language models in medicine.” Nature Medicine. (doi:10.1038/s41591-023-02448-8)
- Laboratuvar Otomasyonu: Boiko, D. A., et al. (2023). “Autonomous chemical research with large language models.” Nature. (Yazıdaki DNA/Kimya deneyleri örneğinin kaynağı). (doi:10.1038/s41586-023-06792-0)
- Zorlu Bilimsel Benchmarklar: Rein, D., et al. (2023). “GPQA: A Graduate-Level Google-Proof Q&A Benchmark.” arXiv. (arxiv.org)
- Puanlama Sorunları: Zheng, L., et al. (2023). “Judging LLM-as-a-Judge.” NeurIPS. (proceedings.neurips.cc)
- Halüsinasyon Riski: Ji, Z., et al. (2023). “Survey of Hallucination in Natural Language Generation.” ACM Computing Surveys. (doi:10.1145/3571730)